In 2020 kreeg boekhandel Honey & Wax Bookseller in Brooklyn (VSA) een vreemd manuscript in bezit dat bestaat uit 7.000 illustraties van elk 3 vierkante centimeter. De afbeeldingen beslaan 106 losse vellen die vaak lijken op Europese toeristische brochures, en de meeste zijn voorzien van bijschriften die op geen enkele bekende taal lijken. Het manuscript lijkt in de jaren '40 in Zwitserland te zijn gemaakt, maar niemand weet wie het heeft gemaakt of waarom.
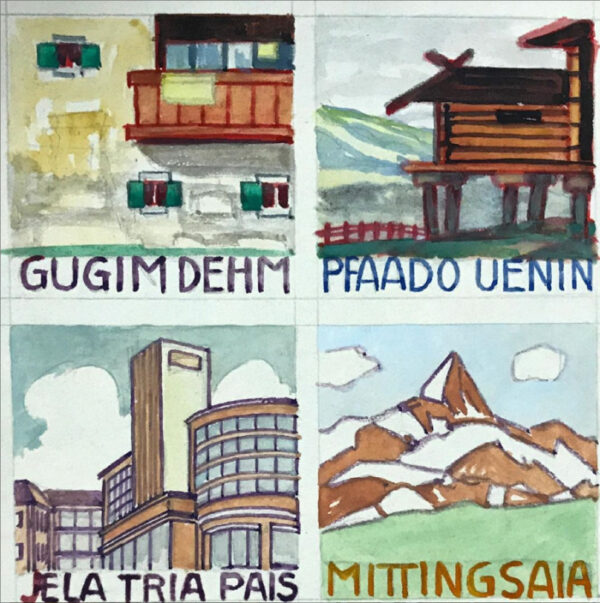
Robert Goulding, wetenschapshistoricus aan de Universiteit van Notre Dame, schreef:
Het feit dat [de woorden] niet lijken te voldoen aan enige taal of fonemen in welke taal dan ook, is verdacht … wat mij doet vermoeden dat het ofwel een code is, ofwel dat er een bepaalde methode of algoritme is gebruikt om de woorden te genereren.
Opgave
Het tekstbestand europa_redux.txt bevat een machine-leesbaar corpus van bijschriften uit het Europa Redux Manuscript. Elke regel bevat een reeks bijschriften $$p \in \mathcal{P}$$ die voorkomen op één vel van het manuscript. Dit is bijvoorbeeld de regel met de bijschriften op het vel dat hierboven staat.
Gugim Dehm|Pfaado Uenin|Jela Tria Pais|Mittingsaia
De verzameling $$\mathcal{P}$$ bestaat uit alle mogelijke reeksen van één of meer bijschriften, die van elkaar gescheiden worden door een verticale streep (|). Een bijschrift bevat zelf nooit een verticale streep.
Letters met diakrische tekens
De bijschriften uit het Europa Redux Manuscript bevatten heel wat letters met diaktrische tekens. Zo'n diakritisch teken is een schriftteken dat boven, onder, vóór, achter of door een letter gezet wordt ter aanduiding van de uitspraak. Een letter o in een reguliere expressie zal enkel matchen met de letter o zonder diakritische tekens, en bijvoorbeeld dus niet met ö, õ, ó of ò. Karakterklassen zoals [:alpha:], [:alnum:], [:lower:] en [:upper:] matchen wel met letters met diaktrische tekens: de eerste drie karakterklassen matchen bijvoorbeeld met alle varianten van de letter o uit de vorige zin, de laatste met geen enkele variant, maar dan enkel omdat het geen hoofdletters zijn.
Gevraagd wordt:
-
Bepaal zo kort mogelijke reguliere expressies voor de volgende deelverzamelingen van $$\mathcal{P}$$:
-
$$\mathcal{P}_1 = \{\,p \in \mathcal{P}\,|\,p\ $$bevat een bijschrift waarin de letters$$^{(*)}$$ van het woord REDUX in die volgorde voorkomen$$\,\}$$
(*) zonder onderscheid te maken tussen hoofdletters en kleine letters
voorbeeld: Mattwilkon|Reumoens-dürjuxser|Gentiron|Sogenxon $$\in \mathcal{P}_1$$Dürrenroth|Genbüssiefin|Ardon|Grüwilden $$\not \in \mathcal{P}_1$$ -
$$\mathcal{P}_2 = \{\,p \in \mathcal{P}\,|\,$$alle bijschriften bestaan uit een hoofdletter gevolgd door vijf of meer kleine letters$$\,\}$$
voorbeeld: Marlenamon|Ennataachos|Orsalilegen|Neuengenbas $$\in \mathcal{P}_2$$Unterterwilnaz|Cointrenles|Rila Mattu|Gohlos $$\not \in \mathcal{P}_2$$ -
$$\mathcal{P}_3 = \{\,p \in \mathcal{P}\,|\,$$het laatste karakter van elk bijschrift verschilt$$^{(*)}$$ van het eerste karakter van het volgende bijschrift$$^{(*)}\,\}$$
(*) zonder onderscheid te maken tussen hoofdletters en kleine letters
voorbeeld: Kehrsatz|Winikon|Senarclens|Miex|Seldonéaz $$\in \mathcal{P}_3$$Rebévelieruw|Walperswil|Homburgis|Kleinandelfingen $$\not \in \mathcal{P}_3$$ -
$$\mathcal{P}_4 = \{\,p \in \mathcal{P}\,|\,p\ $$bevat een bijschrift dat uit drie of meer woorden$$^{(*)}$$ bestaat$$\,\}$$
(*) een woord bestaat uit de langst mogelijke opeenvolging van letters
voorbeeld: Valeyres-sous-Rances|Sternenberg|Maggia|Maseinlen $$\in \mathcal{P}_4$$St. Urban|Petit-Martel|Oberdiessbach|Kesswil $$\not \in \mathcal{P}_4$$
Geef telkens een Unix commando waarin de reguliere expressie gebruikt wordt door een commando uit de grep familie om enkel de regels van het tekstbestand naar stdout te schrijven waarvan het patroon $$p$$ behoort tot $$\mathcal{P}_i\ (i = 1, 2, 3, 4)$$.
-
-
Bepaal als volgt de woorden $$w_1\ w_2\ w_3\ w_4$$ van een geheime boodschap:
-
woord $$w_1$$ bestaat uit het tweede karakter van elk bijschrift op de unieke regel die behoort tot $$\mathcal{P}_1 \cap \mathcal{P}_2$$
-
woord $$w_2$$ bestaat uit het tweede karakter van elk bijschrift op de unieke regel die behoort tot $$ \mathcal{P}_2 \cap \mathcal{P}_3$$
-
woord $$w_3$$ bestaat uit het tweede karakter van elk bijschrift op de unieke regel die behoort tot $$\mathcal{P}_3 \cap \mathcal{P}_4$$
-
woord $$w_4$$ bestaat uit het tweede karakter van elk bijschrift op de unieke regel die behoort tot $$\mathcal{P}_4 \cap \mathcal{P}_1$$
Geef telkens een Unix commando waarin de reguliere expressies voor de verzamelingen $$\mathcal{P}_i\ (i = 1, 2, 3, 4)$$ gebruikt worden door commando's uit de grep familie om het woord $$w_j\ (j = 1, 2, 3, 4)$$ op te zoeken in het tekstbestand en uit te schrijven naar stdout. Hierbij is het niet toegelaten om het woord $$w_j$$ letterlijk uit te schrijven (bv. echo $$w_j$$).
-