We werken met een dataset genaamd historical_data.csv, die informatie bevat over de deelnames van nationale ploegen aan de FIFA wereldbekers in 2002, 2006, 2010, 2014, 2018 en 2022. Het bestand is gedownload van Kaggle en bevat 192 records.
Hieronder de eerste regels van het bestand "historical_data.csv".
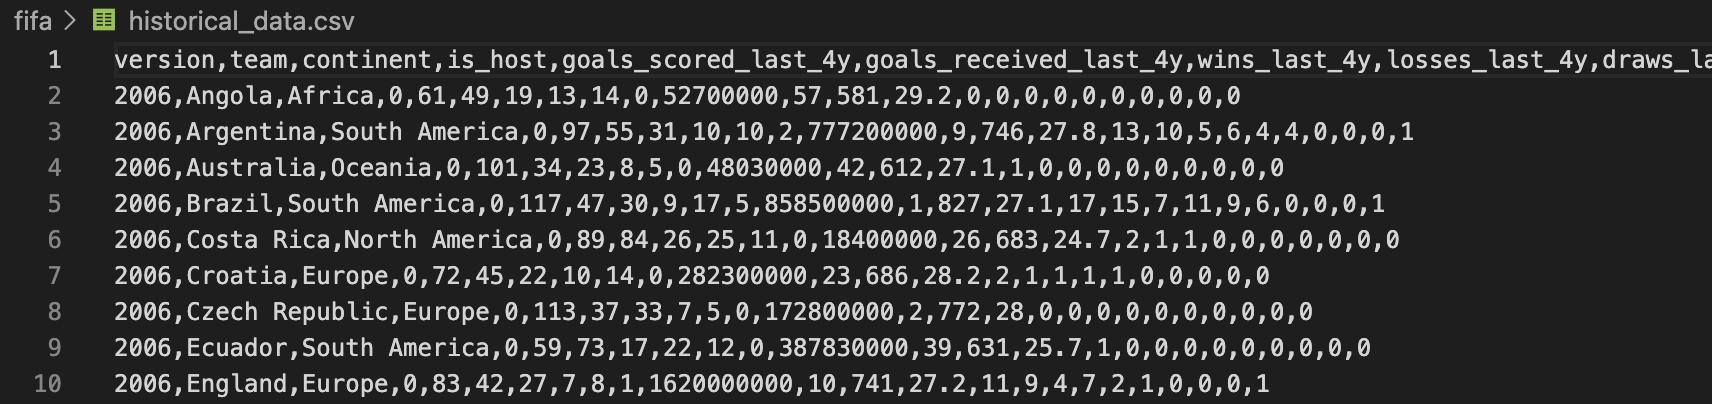
Beschrijving van de data
- version (het jaartal)
- team (het land)
- continent
- is_host
- goals_scored_last_4y
- goals_received_last_4y
- wins_last_4y
- losses_last_4y
- draws_last_4y
- world_cup_titles_before
- squad_total_market_value_eur (de totale marktwaarde van het team in euro's)
- fifa_rank_pre_tournament
- fifa_points_pre_tournament
- squad_avg_age
- world_cup_participations_before
- groups_passed_before
- round16_before
- quarterfinals_before
- semifinals_before
- finals_before
- >winner
- finalist
- semi_finalist
- quarter_finalist
Enkel de kolommen die vet gedrukt zijn, zijn relevant voor deze analyse.
Databestand
Het bestand is beschikbaar in het working directory van Dodona. Om te debuggen in PyCharm of in een Jupyter Notebook) zal je het bestand moeten downloaden en bewaren in dezelfde map als je .py of .ipynb bestand.
Je kan het bestand hier downloaden:
Opgave
- Functie
deelnamesSchrijf een functie
deelnamesmet één parameter: land (string)De functie leest het databestand in en retourneert een lijst met alle deelnames van het opgegeven land, in de volgorde zoals ze voorkomen in de oorspronkelijke dataset.
Per deelname wordt een sublijst toegevoegd aan de outputlijst. De sublijst bevat in deze volgorde de volgende gegevens:
- jaartal (int): kolom
version continent(str)- marktwaarde (float): de totale marktwaarde van het team in miljard euro's, afgerond op 2 decimalen. Om dit te berekenen, gebruik je de kolom
squad_total_market_value_eur. Voor sommige records is deze kolom niet ingevuld, in dat geval wordt 'N/A' genoteerd als marktwaarde.
Als het land niet voorkomt in de dataset, retourneert de functie een lege lijst.
Voorbeelden
>>> deelnames("Belgium")
[[2018, 'Europe', 0.75], [2022, 'Europe', 0.56], [2014, 'Europe', 0.35], [2002, 'Europe', 'N/A']]

>>> deelnames("Mali")
[]
- jaartal (int): kolom
- Functie
marktwaarde_per_continentSchrijf een functie
marktwaarde_per_continentmet één parameter:continent(str)De functie doet het volgende:
- Leest het CSV-bestand in en haalt daaruit een lijst van alle landen in de dataset die tot het opgegeven continent behoren.
- Voor elk land worden volgende waarden berekend:
aantal_deelnames(int): Het aantal keren dat het land deelnam aan een WK (op basis van de beschikbare gegevens).gemiddelde_marktwaarde(float): De gemiddelde marktwaarde van het land, afgerond op 2 decimalen - gebaseerd op de deelnames waarvoor gegevens beschikbaar zijn. Dit gemiddelde wordt niet afgerond. Als er uitzonderlijk geen gegevens beschikbaar zijn, wordt 'N/A' genoteerd.- Retourneert een geneste dictionary met als sleutels de landen en als waarden opnieuw een dictionary met de berekende waarden voor elk land (zie voorbeelden). Als het continent niet voorkomt in de dataset, retourneert de functie een lege dictionary.
- Functie
hoogste_marktwaarde_per_continentSchrijf een functie
hoogste_marktwaarde_per_continentmet één parameter:continent(str)De functie gaat op zoek naar het land met de hoogste marktwaarde in het opgegeven continent en retourneert:
- Als er geen enkel land in het continent heeft deelgenomen: de string
"Geen gegevens beschikbaar voor continent." - Anders: de string
"Het land met de hoogste gemiddelde marktwaarde in continent is land met een gemiddelde marktwaarde van marktwaarde miljard euro."Schuingedrukte woorden worden vervangend door de daadwerkelijke waarden.
Let op: de marktwaarde wordt afgerond op 2 decimalen. Als het tweede decimaal een nul is, wordt het ook weergegeven. Gebruik de format string om dit te realiseren.
Je mag er van uitgaan dat de gegevens in de dataset zo zijn en dat er geen dubbele waarden zijn voor de hoogste marktwaarden in de opgegeven continenten.
Voorbeelden
>>> hoogste_marktwaarde_per_continent('Oceania') "Het land met de hoogste gemiddelde marktwaarde in Oceania is Australia met een gemiddelde marktwaarde van 0.04 miljard euro." >>> hoogste_marktwaarde_per_continent('Antarctica') "Geen gegevens beschikbaar voor Antarctica."
- Als er geen enkel land in het continent heeft deelgenomen: de string
Voorbeelden
>>> marktwaarde_per_continent('Oceania')
{'Australia': {'aantal_deelnames': 5, 'gemiddelde_marktwaarde': 0.038}, 'New Zealand': {'aantal_deelnames': 1, 'gemiddelde_marktwaarde': 0.02}}


>>> marktwaarde_per_continent('Antarctica')
{}